一、Ollama 本地单卡轻型探索快船部署
针对离线保密研究、低延迟本地 IDE 插件驱动,DeepSeek 官方发布了基于 GGUF/AWQ 的量化蒸馏模型。在已安装 Ollama 的个人设备上仅需单行命令即可启动:
ollama run deepseek-r1:14b
ollama run deepseek-r1:32b
ollama run deepseek-r1:70b
部署后 Ollama 会在本地监听 http://localhost:11434 端口,可无缝对接任何兼容 OpenAI 的第三方前端或终端客户端。
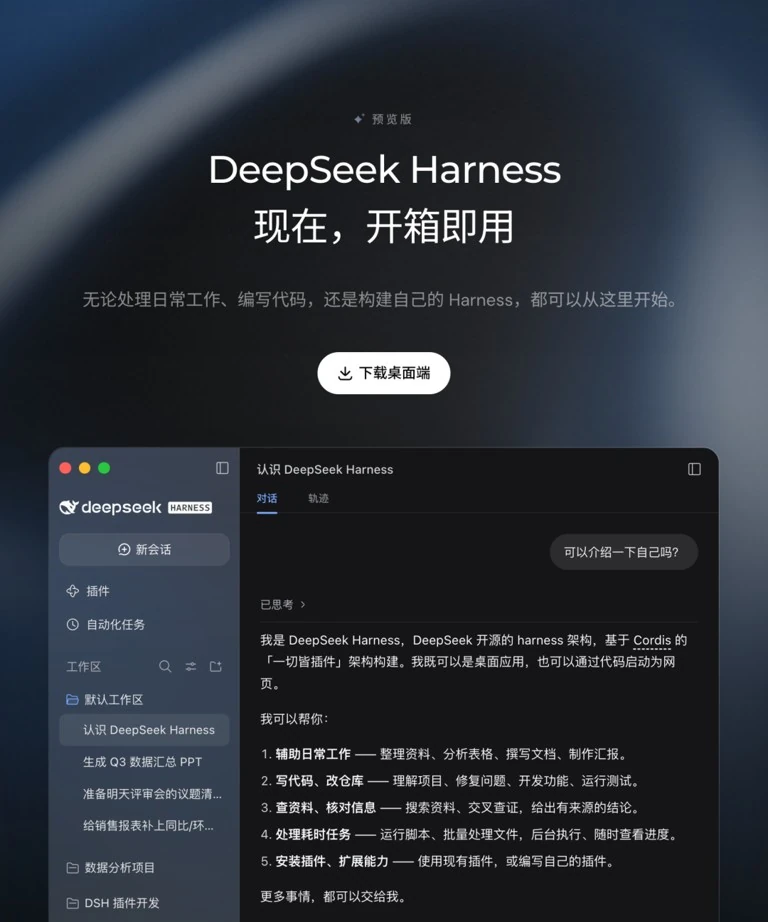 图 1 · 航行日志 · 开发者在本地工作站通过终端与图形化开发环境调用 DeepSeek 离线模型
二、vLLM 多卡远洋旗舰集群加速
面向高并发企业级服务,建议采用 vLLM 作为分布式推理加速后端。得益于 DeepSeek 原生 MLA(Multi-head Latent Attention)机制,显存开销相较传统架构大幅压缩。
python3 -m vllm.entrypoints.openai.api_server \
--model deepseek-ai/DeepSeek-R1 \
--tensor-parallel-size 8 \
--trust-remote-code \
--port 8000 \
--max-model-len 65536 \
--kv-cache-dtype fp8 \
--enable-chunked-prefill
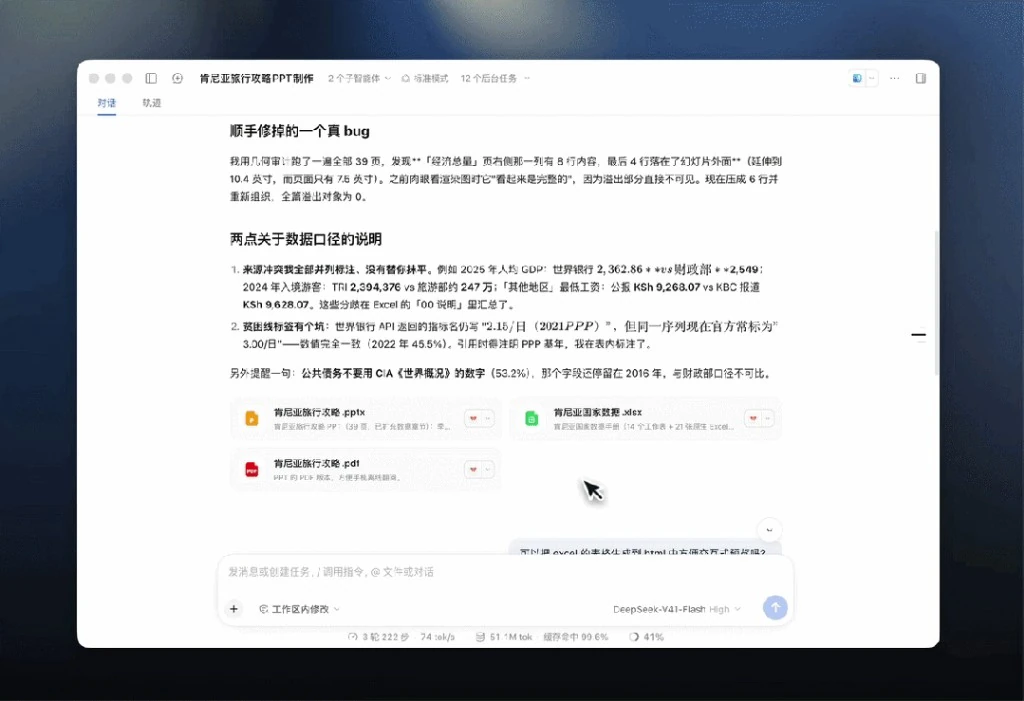 图 2 · 承载千万级推理吞吐的分布式计算中心与冷液冷高密机柜
三、DeepSeek api开放平台港口税则 (Port Tariff)
DeepSeek 坚持极具透明度与竞争力的港口税则定价体系。依托全自动 Context Caching(上下文智能复用)策略,大幅削减企业客户的长文本与多轮对话开销。
| 港口通行船型 (模型代号) |
通航窗口 |
进港输入费率 (未命中缓存) |
进港免税费率 (命中缓存) |
出港生成费率 |
| deepseek-chat (V3 通用旗舰) |
128K |
1.0 元 / 百万 Tokens |
0.25 元 / 百万 Tokens |
2.0 元 / 百万 Tokens |
| deepseek-reasoner (R1 推理主力) |
128K |
2.0 元 / 百万 Tokens |
0.50 元 / 百万 Tokens |
8.0 元 / 百万 Tokens |
注:在调用 deepseek-reasoner 时,API 返回包含 reasoning_content(思维链)与 content(最终答案),均按标准出港 Token 计费。
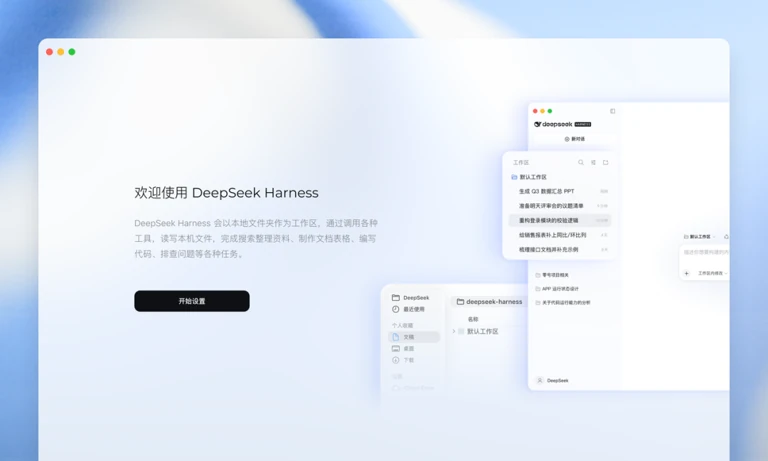 图 3 · 开发者控制台实时 Token 用量、缓存命中率与并发度仪表盘
四、DeepSeek Harness 自动化沙箱评测规程
DeepSeek Harness 是为长思维链逻辑推演设计的端到端沙箱评测套件,具备严苛的防数据污染与去重检测机制。
python3 -m deepseek_harness.evaluate \
--model-endpoint "http://localhost:8000/v1" \
--dataset math500,aime2024 \
--sandbox-env docker \
--temperature 0.6 \
--num-samples 16
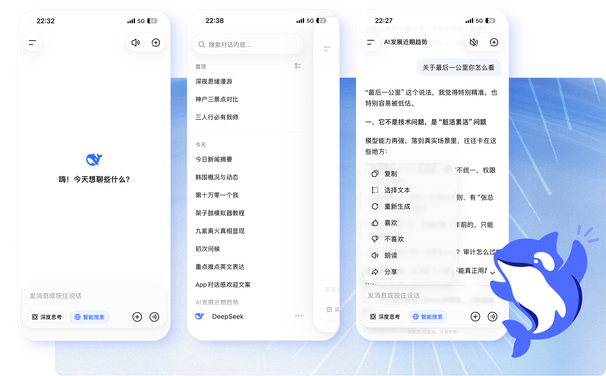 图 4 · DeepSeek Harness 自动化评测矩阵与测试报告输出
五、航海常见疑难解答 (FAQ)
问:DeepSeek-R1 纯强化学习模型与传统大模型最根本的差异是什么?
答:传统模型高度依赖人类标注示范(SFT),容易局限于人类已知思路并在长链条推导中产生幻觉积累;而 DeepSeek-R1 采用大规模纯强化学习(Large-Scale RL),模型在规则严格的数学和编程反馈环境中自主探索解题航道,自发掌握了反思假设、推翻错误与多方案对比的严密逻辑机制。
问:企业如何申请私有化信创交付或算力专线?
答:DeepSeek 支持在金融量化、高端制造、能源仿真等领域进行全栈私有化内网交付。企业客户可通过官方技术服务渠道对接。
问:如何联系 DeepSeek 官方航海支持团队?
答:如有技术咨询、评测合作或商务接洽,请直接联系官方航海通讯邮箱:service@deepseek.com。